MCP 服务器
从 2025.2 版本开始,GoLand 随附集成的 MCP 服务器 ,允许 Claude Code、Codex、VS Code 等外部客户端访问 IDE 提供的工具。 这让用户能够在不离开所选应用程序的情况下控制 JetBrains IDE 并与其交互。
启用 MCP 服务器插件
此功能依赖于 MCP 服务器插件,该插件在 GoLand 中默认捆绑并启用。 如果相关功能不可用,请确保您未禁用该插件。
按下 Ctrl+Alt+S 打开设置,然后选择 。
找到 MCP 服务器 插件并点击 启用。
启用 MCP Server
要启用 MCP 服务器,请执行以下操作:
转到 。
请选择 启用 MCP Server 复选框。
在 启用 MCP 服务器? 对话框中,查看第三方应用程序将获得对 IDE 中已打开项目的哪些访问权限,然后点击 启用 继续。
点击 Apply。
启用 MCP 服务器后,可以继续配置外部客户端。
外部客户端设置
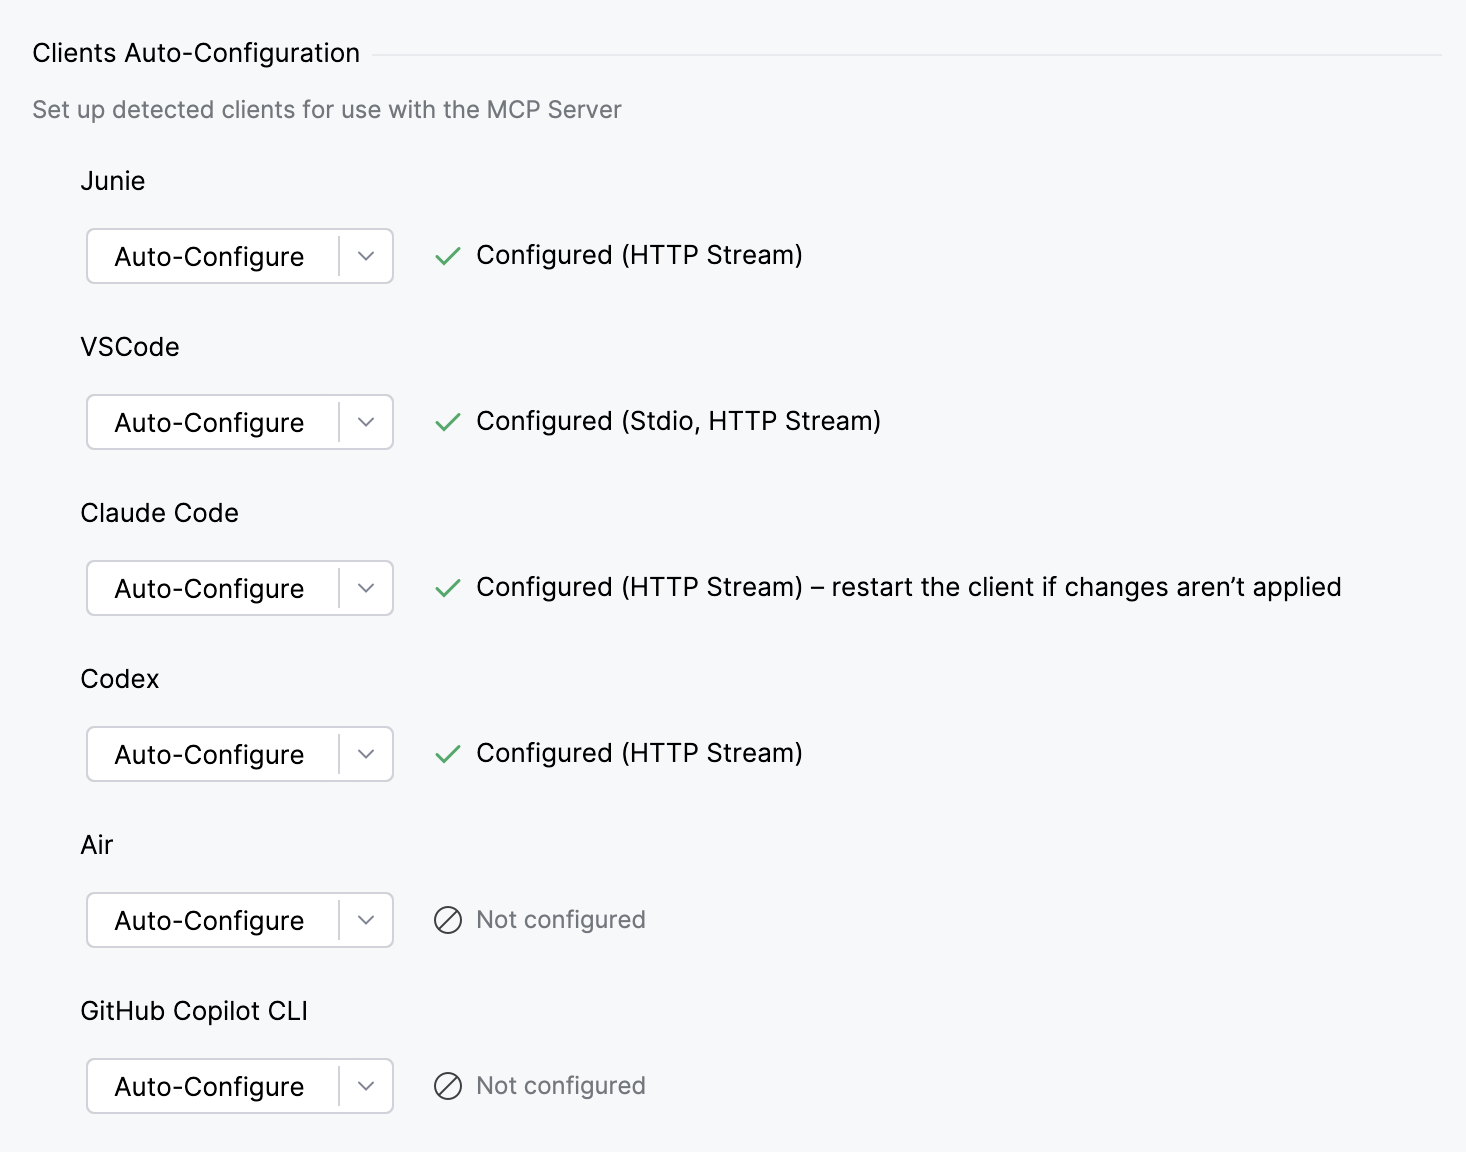
对于检测到的外部客户端,如 Junie、 VS Code、 Claude Code、 Codex、 Air 和 GitHub Copilot CLI ,可以自动执行配置。 设置客户端意味着将 IDE MCP 服务器的地址添加到该客户端的配置文件中。
为此:
转到 。
在 客户端自动配置 部分中,为每个要与 MCP server 配合使用的客户端点击 自动配置。 这会自动更新客户端的配置文件。 已配置的传输设置取决于客户端。
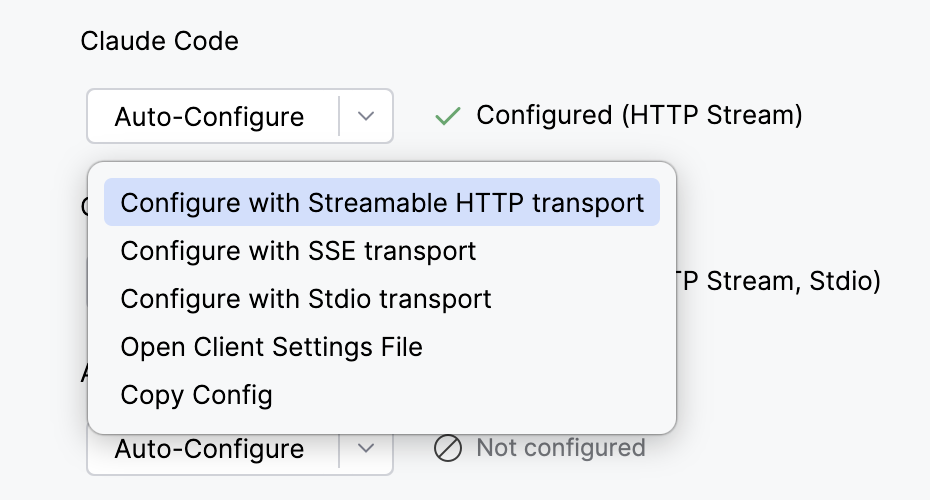
要自行配置特定传输,请点击
 ,该项位于 自动配置 旁边,然后从列表中选择所需选项。
请重启客户端以使配置生效。
项目级客户端设置
某些客户端还会从项目的工作目录读取配置文件。 对于这些客户端,IDE 可以将连接设置直接写入当前打开项目中的配置文件,因此 MCP 服务器仅在处理该项目时可用。
如果处理多个项目,并且不希望为每个客户端会话注册 MCP 服务器,请使用此选项。
转到 。
在 项目客户端自动配置 部分中,针对要设置的每个客户端点击 自动配置。 这会自动更新客户端的项目级配置文件。
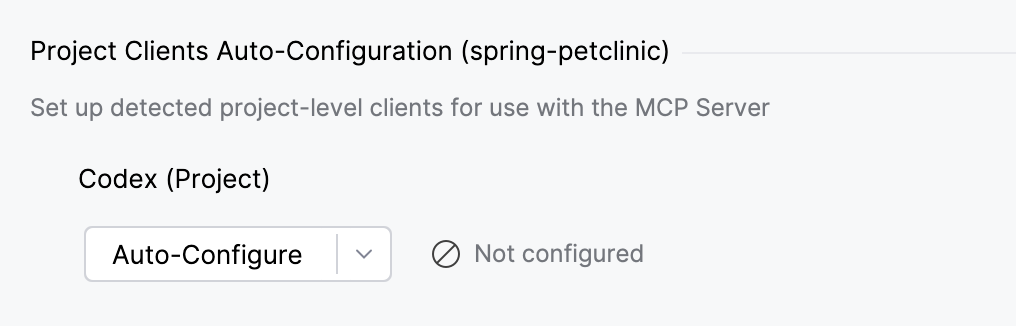
如果要配置特定传输机制,请点击
,该项位于 自动配置 旁边,然后从列表中选择所需选项。请重启客户端以使配置生效。
手动客户端设置
如果要连接的客户端不在列表中,请手动配置。
在 手动客户端配置 部分,根据连接类型点击 复制 SSE 配置、 复制 Stdio 配置 或 复制 HTTP 流配置。
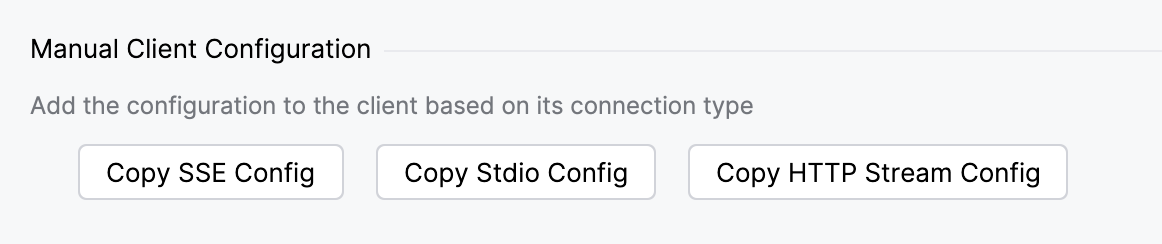
将复制的配置粘贴到客户端的设置或配置文件中。
请重启客户端以使配置生效。
无确认执行操作
MCP server 允许连接的外部客户端在 IDE 中执行终端命令或运行配置时无需每次确认。
启用此模式的方法如下:
转到 。
在 命令执行 部分中启用 在无确认情况下运行 shell 命令或运行配置(勇敢模式) 设置。
点击 Apply。
在终端会话中显示设置建议
当 Codex 或 Claude 在没有匹配 MCP 服务器设置的终端会话中启动时,IDE 可以显示一个建议配置连接的横幅。
要控制此行为:
转到 。
在 终端会话 部分中,选中或清除 显示 Codex 和 Claude 终端会话的设置建议 复选框。
点击 Apply。
支持的工具
MCP 服务器提供一组工具,使外部客户端可以与 IDE 和项目交互,例如分析代码、修改文件、运行配置或执行终端命令。
可以在 中查看和管理全部可用工具列表。 对于每个工具,选中或清除 已启用 复选框,以控制是否向外部客户端公开该工具。
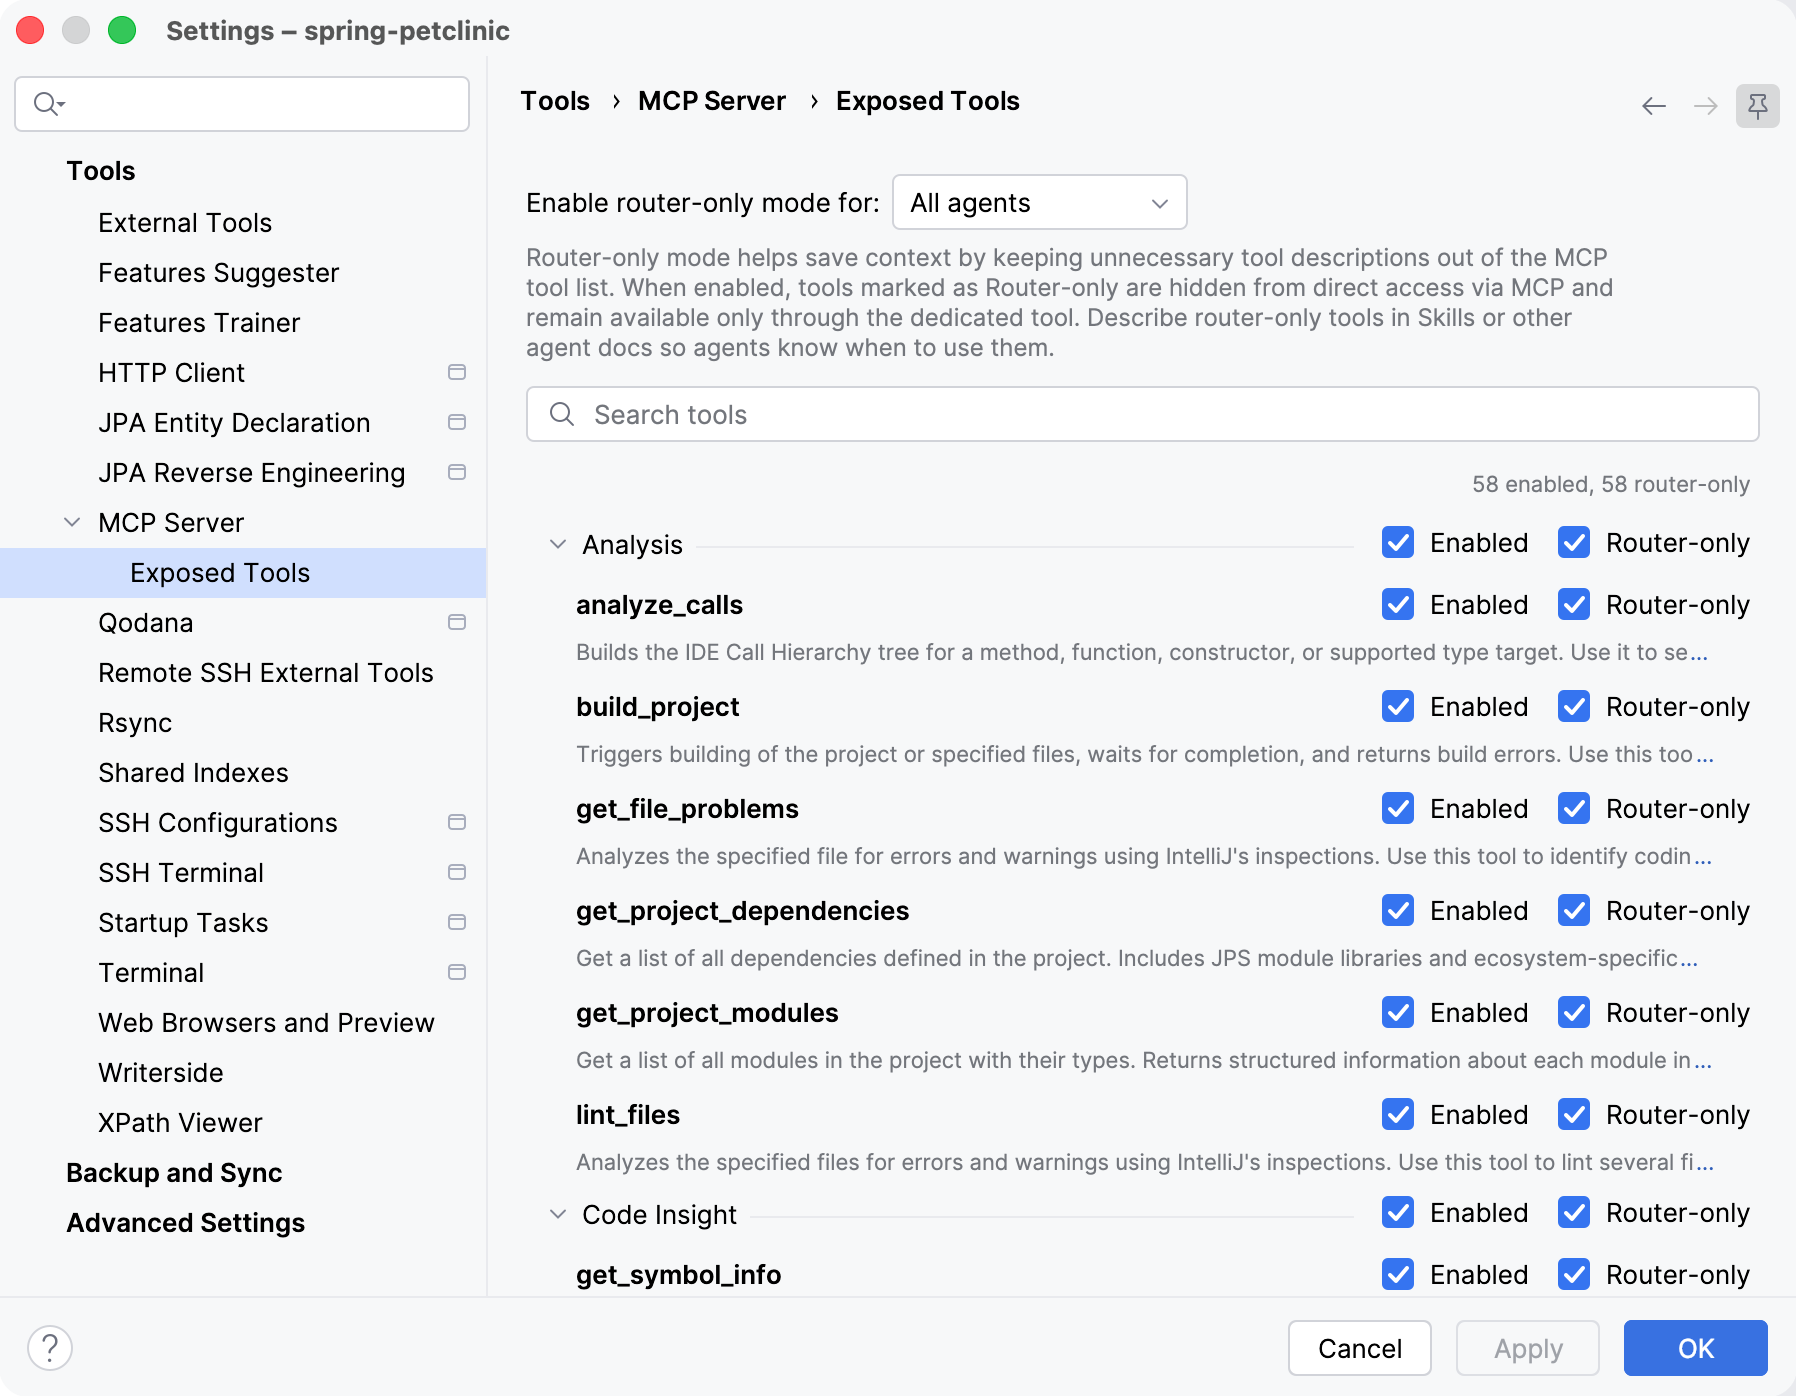
也可以为工具选中 仅路由器 复选框。 仅路由器工具会从直接 MCP 工具列表中隐藏,并且只能通过专用路由器 工具 使用。 这样可以避免工具列表中出现不必要的工具描述,并节省上下文。 使用 为以下对象启用路由器专用模式 设置指定仅路由器模式何时适用,例如用于 所有智能体 或 仅限 ACP 智能体。
下方可以找到由 MCP 服务器提供的工具列表。
分析工具
- analyze_calls
为方法、函数、构造函数或受支持的类型目标构建 IDE 调用层次结构树。 使用它查看谁调用了符号(
INCOMING_CALLS)或该符号调用了什么(OUTGOING_CALLS)。按实际调用评估依赖项时,优先使用此工具,而不是用法搜索、文本搜索或正则表达式搜索。 它使用 IDE 调用层次结构数据,因此相比原始搜索,能够提供更精确的调用关系,并且噪音更少、后续调用更少。
将
symbolFqn作为完全限定名称传递,例如com.example.Service.run。 如果名称存在歧义,工具会返回精确签名;请将其中一个作为symbolFqn传回。 如果只知道短名称或片段,请先使用搜索符号查找目标。结果是一个可展开的文本树。 每个节点都包含
filePath和treePath;filePath在可能的情况下相对于项目。 将treePath传回以渲染子树。 使用childOffset继续处理截断的 …… 以及另外 n 个 行。depth、maxChildren和maxNodes限制渲染树的范围。 当 IDE 能够解析符号时,符号可以来自项目源、源 jar 或反编译的二进制 jar 依赖项。参数:
symbolFqn(必需):普通完全限定符号名称,或由歧义错误返回或从已渲染子节点复制的精确签名。 如果只知道短名称或片段,请先使用搜索符号,并在此处传递最佳完全限定可调用名称。 示例:com.example.Service.run、com.example.Service.run(String)或org.assertj.core.api.Assertions.assertThat(String)。 不要传递文件路径、行、列或单独的目标签名。analysisKind(必需):调用分析方向。 使用INCOMING_CALLS显示symbolFqn的调用方,或使用OUTGOING_CALLS显示从symbolFqn调用的符号。depth:在请求的子树根下方渲染的最大调用级别数。 默认值为 5。 使用 0 仅渲染子树根。maxChildren:为每个节点渲染的直接子节点最大数量。 默认值为 50。maxNodes:渲染的调用节点总数上限。 默认值为 1000。treePath:可选的子树根路径,从先前的analyze_calls结果中精确复制。 Null 或省略表示根路径[]。 每个组件都是精确签名,而不是显示名称。childOffset:对treePath指向的节点的直接子节点进行分页时使用的偏移量。 默认值为 0。超时:超时时间(毫秒)。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- 构建项目
触发项目或指定文件的构建,等待补全,并返回构建错误。 可使用此工具构建项目或编译文件,并获取有关编译错误和警告的详细信息。
编辑后需使用此工具验证修改是否有效。
参数:
rebuild:是否对项目执行完全重建。 默认为 false。 仅当未指定filesToRebuild时有效。filesToRebuild:如指定,则仅编译指定路径的文件。 路径为相对于项目根目录的位置。超时:超时时间(毫秒)。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- get_file_problems
使用 IntelliJ 检查分析指定文件中的错误和警告。 使用此工具可识别特定文件中的编码问题、语法错误及其他问题。
返回问题列表,包括严重性、描述与位置信息。
参数:
filePath:相对于项目根目录的路径。errorsOnly:是否仅包含错误,或包含错误和警告。超时:超时时间(毫秒)。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- get_project_dependencies
返回项目中定义的所有依赖项列表。 提供关于库名称的结构化信息。
参数:
projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- get_project_modules
返回项目中所有模块及其类型的列表。 提供每个模块的结构化信息,包括其名称和类型。
参数:
projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- lint_files
使用 IntelliJ 检查分析指定文件中的错误和警告。 编辑多个文件后,使用此工具对这些文件进行 lint。 返回每个文件的问题,包括严重性、描述和位置信息。
当单个文件超出可用预算时,批量响应可能包含带有
timedOut: true且problems为空的文件条目。 带有notAnalyzedReason的文件条目表示无法分析的文件,例如项目内容根之外的文件、已排除文件或不支持的文件类型。 顶层more: true表示批处理不完整。参数:
files(必需):要分析的项目相对文件列表。 重复路径在规范化后会被忽略。min_severity:要包含的最低严重性:warning或error。 默认值为warning。超时:超时时间(毫秒)。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
代码洞察工具
- get_symbol_info
检索指定文件中指定位置的符号信息。 提供与 IntelliJ IDEA 的 快速文档 功能相同的信息。 信息可能包括符号名称、签名、类型、文档及其他细节,具体取决于编程语言。
如果该位置引用了符号,工具将在可能的情况下返回包含符号声明的代码片段。 使用该工具以了解符号的声明、语义及其位置。
参数:
filePath:相对于项目根目录的路径。line:从 1 开始的行号。column:从 1 开始的列号。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
特定数据库工具
要确保 AI 代理只能严格以只读方式访问,请使用权限适当受限(只读)的数据库用户,并配置数据源使用该用户。
- cancel_sql_query
使用其唯一ID取消正在运行的查询。
参数:
sessionId:查询会话ID。
- 创建数据库连接
按名称、DBMS(
dbms)、JDBC URL(url)以及用于检查连接的标志(needToCheckDs)创建新的数据库连接(数据源)。 所有参数均为必需。 返回连接诊断信息。参数:
名称(必需):数据库连接的唯一名称。dbms:数据库管理系统(DBMS)的名称。url:数据库连接的完整 JDBC URL,例如jdbc:postgresql://<host>:<port>/<database>。needToCheckDs:是否在创建或编辑数据源后立即测试连接。 批量配置多个连接时设置为false— 每个连接的探测开销较高,而test_database_connection可针对重要连接显式调用。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- 编辑数据库连接
编辑由
connectionId标识的现有数据库连接(数据源)。 更新连接的 DBMS 驱动程序和 JDBC URL;连接名称会保留。 返回连接诊断信息。参数:
connectionId:唯一连接ID。dbms:数据库管理系统(DBMS)的名称。url:数据库连接的完整 JDBC URL,例如jdbc:postgresql://<host>:<port>/<database>。needToCheckDs:是否在创建或编辑数据源后立即测试连接。 批量配置多个连接时设置为false— 每个连接的探测开销较高,而test_database_connection可针对重要连接显式调用。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- execute_sql_query
针对指定数据库连接执行SQL查询。
该工具报告执行状态:成功或错误。 对于错误,还会提供错误描述。
如果查询返回数据,则以 CSV 格式附加到工具响应中。
参数:
connectionId:唯一连接ID。queryText:要执行的SQL查询。
- 获取查询结果
按 ID 从已执行的查询中获取行,从给定的行偏移量开始。 返回与
execute_sql_query相同的结构:resultSetId以及 CSV 格式的渲染结果。使用此工具对先前由
execute_sql_query或preview_table_data返回的resultSetId进行分页。参数:
resultSetId(必需):先前execute_sql_query或preview_table_data调用返回的不透明结果集 ID。offset(必需):开始获取的行偏移量。 默认值为 0。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- 获取数据库对象描述
检索特定架构内数据库对象(列、类型、密钥、索引)的结构,并以分层文本表示。
如有歧义,将返回所有相关对象的定义。
参数:
connectionId:唯一连接ID。databaseName:该架构所属数据库的名称。 如果DBMS没有数据库而只有架构,则此项可以为空。schemaName:架构名称。kind:将此参数设置为某一对象类型编码,仅列出该类型的对象。 将其设置为null以检索架构中的所有对象。objectName:指定类型对象的名称(如表或视图名)。 不能为空。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- 内省架构
内省数据库架构,将其元数据(表、列和索引)加载到本地模型中。 当架构的
isIntrospected标志为 false,并且需要调查架构结构或刷新过期元数据时,请使用此项。 返回架构标识符以及更新后的内省状态。参数:
connectionId:唯一连接ID。databaseName:该架构所属数据库的名称。 如果DBMS没有数据库而只有架构,则此项可以为空。schemaName:架构名称。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- list_database_connections
检索项目中已配置的数据库连接或数据源列表。 对于每个连接,会返回其唯一 ID、名称、DBMS 和驱动程序名称。
- list_database_schemas
检索指定数据库连接中的数据库架构列表。
对于每个架构,工具返回该架构本身的名称以及数据库名称(如不适用则为空)。
参数:
connectionId:唯一连接ID。selectedOnly:仅列出数据库树中选中的架构为真;全部列出则为假。
- list_recent_sql_queries
免费订阅计划不支持此功能。
检索给定数据库连接的近期(包括当前运行中)查询列表。
对于每个查询,返回以下内容:
查询会话的唯一ID。
查询运行所花费的时间(以毫秒为单位)。
查询的当前状态。 例如,运行中、取消中、已完成等。
查询的完成状态。 例如,成功、完成但有错误、已取消等。
查询文本。
参数:
connectionId:唯一连接ID。
- list_schema_object_kinds
检索给定数据库连接支持的架构对象类型列表。 对于每种对象类型,返回该类型的唯一编码和可读名称。
参数:
connectionId:唯一连接ID。
- list_schema_objects
检索指定架构中的数据库对象列表。 对于每个对象,返回其在架构中的名称及类型。
参数:
connectionId:唯一连接ID。schemaName:架构名称。databaseName:该架构所属数据库的名称。 如果DBMS没有数据库而只有架构,则此项可以为空。kind:将此参数设置为某一对象类型编码,仅列出该类型的对象。 将其设置为null以检索架构中的所有对象。
- preview_table_data
使用指定数据库连接返回表、视图、物化视图或其他类似表对象的预览数据。
该工具以CSV格式返回表内容。
参数:
connectionId:唯一连接ID。schemaName:架构名称。databaseName:该架构所属数据库的名称。 如果DBMS没有数据库而只有架构,则此项可以为空。tableName:表名称。maxRowCount:要返回的最大行数。 默认值为100。
- test_database_connection
返回连接诊断信息:
指示该连接是否存在问题的标志:是、否或未知。
包含数据库连接的详细信息,如 DBMS 类型、版本以及 JDBC 驱动程序。
连接尝试结果摘要。 如果失败,包含DBMS提供的错误描述。
参数:
id:唯一连接ID。
执行工具
- execute_run_configuration
运行当前项目中按名称指定的已存在运行配置,或由代码位置(
filePath+line)创建的临时运行配置,然后最多等待指定的超时完成。 此工具需配合get_run_configurations返回的配置名称,或配合get_run_configurations(filePath = ...)返回的运行点(filePath+line)使用。可选的启动重写(
programArguments、workingDirectory、envs)仅对本次运行生效且不会被保留。 除非明确需要更改本次运行的已配置启动值,否则不要传递这些重写参数。 缺失/null 的重写参数会保持现有运行配置值不变。 对于字符串重写(programArguments、workingDirectory),缺失/null 或空字符串("")会保持现有值不变。 传递如" "这样的仅空格字符串用于清空此次启动的现有值。传递
configurationName,或filePath与line一起。 这些模式互斥。行为:
waitForExit=true时,最多等待超时毫秒以等待进程结束。 如果超时,进程将在后台继续运行,并且结果中会省略exitCode。waitForExit=false时,仅等待进程启动,随后立即返回,不会应用超时。fullOutputPath指向包含完整原始输出的临时文件,进程存活期间其内容可能持续增长。
返回执行结果,包括当前输出快照、可选退出码及可选
fullOutputPath。参数:
configurationName:要执行的现有运行配置的名称。filePath:相对于项目根目录的文件路径。 配合line一起提供,可从代码上下文创建并执行临时运行配置。line:为filePath指定的从 1 开始的行号。 配合filePath一起提供,且不可与configurationName同时使用。超时:超时时间(毫秒)。waitForExit:是否等待进程结束。 如为 false,工具会在进程启动后立即返回,并忽略超时。programArguments:此启动仅可选的程序实参重写。 缺失/null 或空字符串保留现有值,仅空格字符串则会清空现有值。workingDirectory:此启动仅可选的工作目录重写。 缺失/null 或空字符串保留现有值,仅空格字符串则会清空现有值。envs:此启动仅可选的环境变量重写。 缺失/null 时保持现有环境不变;如有提供,值将覆盖合并到现有环境。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- get_run_configurations
根据输入,返回项目运行配置或可执行文件代码位置。
未提供
filePath时,此工具列出项目现有的运行配置。 结果包含配置名称及可用时的启动详情,如程序实参、工作目录、环境变量及supportsDynamicLaunchOverrides。supportsDynamicLaunchOverrides是execute_run_configuration和xdebug_start_debugger_session中一次性启动重写(programArguments、workingDirectory、envs)的权威功能标志。 仅当该标志为true时,才传递这些重写参数给所选配置。提供
filePath时,此工具会在该文件中发现可执行文件入口点(运行点),例如测试方法、main 方法或 IDE 显示运行装订区域图标的其它可执行文件入口点。 结果中包含filePath和runPoints;可用返回的行号配合execute_run_configuration从代码运行。参数:
filePath:可选的相对于项目根目录的文件路径。 如有提供,将返回该文件的运行点(可执行文件入口点),而不是项目范围的运行配置。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
文件工具
- create_new_file
在项目目录中的指定路径创建一个新文件。 可选地将提供的文本写入文件中。
参数:
pathInProject:文件应相对于项目根目录创建的路径。text(可选):写入新文件的内容。overwrite:是否覆盖现有文件。 如果设置为false,在发生冲突时将抛出异常。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- get_all_open_file_paths
返回当前活动编辑器或任意打开编辑器中用于编辑的所有文件路径,相对于项目根目录。 使用此工具可查看当前打开的编辑器。
参数:
projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- list_directory_tree
以类
tree实用工具的伪图格式,提供指定目录的树状表示。 使用此工具可查看某个目录或整个项目的内容。 相比ls或dir等命令行工具,优先使用此工具列出目录内容。参数:
directoryPath:相对于项目根目录的路径。maxDepth:最大递归深度。超时:超时时间(毫秒)。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- open_file_in_editor
在 JetBrains IDE 编辑器中打开指定文件。 需要一个包含待打开文件路径的
filePath参数。 文件路径可以是绝对路径,也可以是相对于项目根目录的路径。参数:
filePath:相对于项目根目录的路径。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
格式设置工具
- reformat_file
在 JetBrains IDE 中重新格式化指定的文件。 使用此工具可根据路径对文件应用代码格式化。
参数:
path:相对于项目根目录的路径。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
Go 分析器工具
从 2026.3 版本开始,可以使用这些工具通过分析器运行 Go 应用程序、捕获分析数据并分析已保存的分析数据。 使用前请 启用捆绑的 MCP 服务器。
分析会话用于标识一次运行,并具有类似 s1 的 ID。 可以检查从 IDE 或通过 MCP 启动的运行的输出并捕获分析数据。 只有 停止已分析的运行 仅限 MCP 启动的运行。 捕获分析数据需要一个正在运行且分析器已就绪的应用程序。
通过 MCP 捕获的分析数据会作为 PPROF 文件保存到配置的分析数据目录,并添加到 最近配置文件 和会话的分析数据列表中。 它们不会在 Go 优化 工具窗口中自动打开。
每个会话都有一个由 MCP 工具和 IDE 工具栏共享的 CPU 记录。 可以从 IDE 停止由代理启动的记录,代理也可以停止从 IDE 启动的记录。 在已有记录处于活动状态时启动另一个 CPU 记录会返回错误。
- run_with_profiler
使用分析器启动现有的本地 Go Build 运行配置。 该配置需要构建并运行应用程序。 不支持测试配置以及带有远程运行目标的配置。
启动遵循 MCP 服务器的 命令执行确认设置。 如果配置已在运行,请停止该运行,或在配置中启用并行运行后再启动另一个实例。
参数:
runConfig:必需字符串。 运行配置的确切名称。 使用get_run_configurations列出现有配置。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
返回一个对象,其中包含
session、会话 ID,以及profiles,即从可用分析数据名称到样本类型的映射。 该映射仅包含正在运行的应用程序中可用的分析数据:分析数据名称
样本类型
cpusamples、cpuheap、heap_gc、allocsalloc_objects,alloc_space,inuse_objects,inuse_spaceblock、mutexcontentions、delaygoroutinegoroutinegoroutineleakgoroutineleak结果描述的是可用类型,而不是收集到的分析数据。 使用
采集性能分析或 CPU 记录工具来捕获数据。- 停止已分析的运行
停止由
使用分析器运行启动的活动会话的应用程序,无需再次显示确认对话框。 要停止从 IDE 启动的运行,请使用 IDE 控件。参数:
session:必需字符串。 由run_with_profiler返回的会话 ID。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
最多等待 30 秒以使进程停止。 成功时返回
Profiled run stopped for session '<id>'。 如果进程未在该时间内停止,则返回错误。- list_profiled_runs
列出正在运行和最近停止的分析器会话,包括从 IDE 启动的运行。 该列表会保留所有正在运行的运行,以及最近停止的五个运行,直到关闭项目。 列出的运行可能仍在启动,也可能在分析器就绪之前已失败。
参数:
projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
可用时,返回带有
session、名称、isRunning和exitCode的runs。 该列表按最近的启动或停止时间排序。- 获取已分析运行的输出
读取正在运行或保留的已停止会话捕获的标准输出和标准错误。 不包含 IDE 系统消息。 每次运行最多保留 1,000,000 个字符;缓冲区已满时会丢弃较旧的行。 关闭项目时会清除输出。
参数:
session:必需字符串。 来自run_with_profiler或list_profiled_runs的会话 ID。startLine:可选整数。 基于零的行索引。 默认为最早保留的行。 可用范围之外的索引会返回错误。maxLines:1 到 1000 之间的整数。 默认为 200。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
可用时,返回
output、startLine、endLine、availableStartLine、availableEndLine、isRunning和exitCode。 结束索引不包含在内。 将endLine作为下一个startLine传递以继续读取。 如果最后一行不完整,请重新读取该行的索引以获取追加到其中的文本。- take_profile
从正在运行的会话捕获分析数据,并将其保存为 PPROF 文件。
参数:
session:必需字符串。 来自run_with_profiler或list_profiled_runs的会话 ID。kind:必需字符串。 可用的分析数据名称,例如cpu、heap或heap_gc。 有关分析数据名称,请参阅使用分析器运行。duration:1 到 300 之间的整数,以秒为单位。cpu必需。 对于所有其他分析数据类型,请省略它。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
返回
session、kind、指向已保存文件的path,以及按照性能分析摘要中为分析数据默认样本类型所述的摘要。 如果无法构建摘要,summaryError会说明原因。 分析数据仍保存在path。例如,
{"session":"s1","kind":"cpu","duration":30}会记录 30 秒的 CPU 分析数据。 取消定时 CPU 捕获会取消该记录,且不会保存分析数据。- 开始 CPU 记录
为正在运行的会话启动 CPU 记录。 将其与
停止 CPU 录制一起使用,可在不提前指定持续时间的情况下记录工作负载。参数:
session:必需字符串。 来自run_with_profiler或list_profiled_runs的会话 ID。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
返回
CPU recording started for session '<id>'。- stop_cpu_recording
停止会话当前的 CPU 记录并保存分析数据。 应用程序会继续运行。 该记录可能是从 IDE 或通过 MCP 启动的。 如果没有活动的 CPU 记录,则返回错误。
参数:
session:必需字符串。 具有活动 CPU 记录的正在运行的会话 ID。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
返回
session、kind、指向已保存文件的path,以及按照性能分析摘要中为分析数据默认样本类型所述的摘要。 如果无法构建摘要,summaryError会说明原因。 分析数据仍保存在path。- list_profiles
列出最近历史记录、打开的标签页或正在运行的会话中的已保存分析数据。
参数:
scope:recent(默认)、open或session。recent作用域列出 最近配置文件 历史记录,该历史记录最多保留 20 个条目。open作用域列出 Go 优化 工具窗口中的分析数据标签页,并将所选标签页置于首位。session作用域列出为正在运行的会话捕获的分析数据。 最近和会话分析数据按最新优先列出。session:当scope为session时需要的字符串。 对于其他作用域,请省略它。 此作用域不支持已停止的会话。limit:1 到 200 之间的整数。 默认值为 5。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
返回
scope和profiles。 每个条目都包含path、已知时的kind,以及open作用域的selected。- profile_summary
汇总已保存的分析数据,包括总计、CPU 使用情况以及最多五个开销最高的函数。
take_profile和stop_cpu_recording已经返回此摘要。 使用此工具分析另一个文件或样本类型,或重试失败的摘要。参数:
profile:必需字符串。 PPROF 文件的路径,例如由take_profile、stop_cpu_recording或list_profiles返回的路径。sampleType:可选字符串,例如cpu或inuse_space。 默认为分析数据声明的默认样本类型;如果未声明有效的默认值,则默认为其最后一个样本类型。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
每个样本都会计入其调用堆栈中最深的项目函数。 如果未找到项目函数,则计入最深的非 SDK Go 函数;如果两者都未找到,则计入叶(最内层)函数。 前两个选择会排除生成的代码。
项目函数的成本包括库和运行时调用,但对其他项目函数的调用会计入这些函数。 要包含对其他项目函数的调用,请将
性能分析顶部帧与sortBy=cumulative一起使用。为每种样本类型返回
totals,其中包含其sampleType、total和unit。 如果分析数据记录了持续时间,结果会包含duration。 对于带有持续时间的 CPU 分析数据,cpuPercent会将 CPU 时间显示为已用时间的百分比。 超过 100 的值表示在多个 CPU 核心上工作。hottest列表最多包含五个函数,按最大绝对开销排序。shownPercent是其净成本占分析数据总计百分比的大小。 每个函数包括:函数和file:函数名称和记录的源路径。cost和costPercent:归属成本及其占分析数据总计的百分比。selfPercent:函数成本中花费在自身代码中的份额。callees:最多三个直接调用的函数,按绝对开销排序。 每个函数都有一个函数名称,以及舍入前至少占父函数成本 5% 的percent。 仅计算归属于父级的样本。lines:最多三行绝对开销最高的行,每行都包含基于一的line编号、cost,以及可用时的source文本。 如果分析数据没有行信息,则列表为空。path和pathPercent:开销最高的调用路径,最多包含六个调用方,以及其占该函数开销的份额。 路径使用性能分析调用路径表示法。 百分比较低表示成本分布在多个路径上。
在比较分析数据中,
selfPercent、被调用方百分比和pathPercent可能超过 100,因为符号相反的成本可能会相互抵消。 有关共享结果约定,请参阅 读取分析结果。- profile_top_frames
对已保存分析数据中的函数进行排名,例如
go tool pprof -top。self值衡量函数自身中的工作;cumulative还包括它调用的函数。 如果函数具有较高的累积值但自身值较低,请使用root检查它调用的函数。参数:
profile:必需字符串。 PPROF 文件的路径,例如由take_profile、stop_cpu_recording或list_profiles返回的路径。root:可选的非空字符串。 不区分大小写的函数名称子字符串。 将结果限制为匹配函数下的帧。 如果没有匹配项,则返回错误。sampleType:可选字符串,例如cpu或inuse_space。 默认为分析数据声明的默认样本类型;如果未声明有效的默认值,则默认为其最后一个样本类型。sortBy:self(默认)或cumulative。 按绝对值最大的项优先排序。limit:1 到 200 之间的整数。 默认值为 10。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
返回
frames,其中包含函数名称、源路径、起始行、自身值和累计值及其百分比。 结果包括可用的sampleTypes、限制前的totalFrames,以及返回帧的shownPercent。 使用root时,还会报告matchedRoots、scopedTotal和scopedPercent;帧百分比使用该范围内的总计。如果分析数据记录了持续时间,结果包括
duration。 对于包含持续时间的 CPU 分析数据,cpuPercent会将 CPU 时间显示为经过时间的百分比。 超过 100 的值表示在多个 CPU 核心上工作。 有关共享结果约定,请参阅 读取分析结果。- 分析调用路径
查找匹配函数的调用方。 当某个函数成本较高并且需要查找导致该成本的调用方时,请在
profile_top_frames之后使用它。 每条路径从堆栈根开始,在遇到第一个匹配函数处结束,因此嵌套匹配会计入外层匹配。参数:
profile:必需字符串。 PPROF 文件的路径,例如由take_profile、stop_cpu_recording或list_profiles返回的路径。target: 必需的非空字符串。 不区分大小写的函数名称子字符串。 如果没有匹配项,则返回错误。sampleType:可选字符串,例如cpu或inuse_space。 默认为分析数据声明的默认样本类型;如果未声明有效的默认值,则默认为其最后一个样本类型。depth: 1 到 64 的整数。 目标上方保留的调用方的最大数量。 默认值为 12。 递归函数计为一个调用方。 更长的路径会从堆栈根丢弃调用方,并以…开始。limit: 1 到 50 的整数。 默认值为 5。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
返回
paths,按最大绝对累计值排序,以及matchedTargets。 每条路径包含由>分隔的函数名称、其累计值及其在targetTotal中所占的百分比。 结果还包括限制前的targetPercent、shownPercent和totalPaths。重复调用会被合并:
×3表示三次出现,×3-19表示跨合并路径的范围。indirect后缀表示经过省略函数的循环。 将profile_top_frames与root搭配使用以检查它们。 有关共享结果约定,请参阅 读取分析结果。- profile_source_lines
按累计成本对匹配函数中的源代码行进行排名,类似于
go tool pprof -list。 在profile_top_frames之后使用它,以定位函数中成本较高的行。 路径和行号指向分析时的构建;当前源文件可能不同。参数:
profile:必需字符串。 PPROF 文件的路径,例如由take_profile、stop_cpu_recording或list_profiles返回的路径。函数: 必需的非空字符串。 不区分大小写的函数名称子字符串。 合并所有匹配函数。 如果没有匹配项,或者分析数据没有针对匹配函数和所选样本类型的行信息或样本,则返回错误。sampleType:可选字符串,例如cpu或inuse_space。 默认为分析数据声明的默认样本类型;如果未声明有效的默认值,则默认为其最后一个样本类型。limit:1 到 200 之间的整数。 所有匹配函数中的最大行数。 默认值为 20。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
返回
函数,其中包含函数名称、源路径和lines。 每行包含其基于一的行号、self、cumulative,以及可用时的source文本。 该工具会选择绝对累计值最大的行,然后按函数和文件对其分组。totalLines统计限制前的行数。 有关共享结果约定,请参阅 读取分析结果。
读取分析结果
分析工具读取已保存的 PPROF 文件,不需要正在运行的会话。 结果包括所选的 sampleType 、完整分析数据的 total ,以及用于值的 unit: ms 表示时间, MB 表示内存(1 MB = 1,048,576 字节),或者对于其他度量使用分析数据的原始单位。 值四舍五入到两位小数。
在 profile_summary 和 profile_source_lines 中, source 包含当前保存的行,保留缩进但不包含换行符。 此文本可能与分析时的构建不同。 如果源不可用或文件匹配不明确,则该字段不存在。 空字符串表示空行。
泛型类型实参显示为 [...] ,分析会合并同一泛型函数的实例化。 函数名称查询使用相同的缩短形式。 例如, Sum[go.shape.int] 匹配 Sum[...]。
对于比较分析数据,结果包括 diff=true。 正值表示测量值增加,负值表示减少。 百分比使用绝对值,因此请使用带符号的值来区分增加和减少。
检查生成器 MCP 工具
- 验证检查KTS
根据规范示例校验 inspection.kts 脚本。 编译该检查并对正例/反例运行。 返回编译状态及详细验证结果。
正例应触发检查(预期有问题)。 反例不应触发检查(禁止行上预期无问题)。
返回整体成功状态、每个示例结果及聚合统计数据。
参数:
inspectionKtsCode:编译和验证的 inspection.kts 脚本内容。pathToSpecification:要校验的规范示例的路径。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
检查 KTS MCP 工具
- 生成检查KTS API
返回目标语言的检查 KTS API 文档。 提供可用于编写 inspection.kts 文件的类和函数列表。
参数:
language:目标语言:'Java' 或 'Kotlin'。wrapInTags:如为 true,则将 API 内容包裹在<API>和<api.kt>标记中。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- 生成检查KTS示例
返回用于目标语言代码生成示例 inspection.kts 模板。 提供已包装 XML 的示例,展示如何使用 InspectionKts API 编写检查。
参数:
language:目标语言:'Java' 或 'Kotlin'。includeAdditionalExamples:如为 true,除模板外还包含其他精选示例。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- 生成 psi 树
为提供的 Java 或 Kotlin 代码创建 PSI 树,并以缩进文本形式返回。 可使用此工具了解编写检查时代码段的 PSI 结构。 输出显示元素类型及其层次结构,并提示何时需要
node.children()。参数:
code:要解析的源代码段。language:目标语言:'Java' 或 'Kotlin'。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- 运行检查KTS
编译 inspection.kts 脚本,并在目标文件上运行。 如有编译错误则返回,否则返回检查发现的问题列表。 开发过程中,可用此工具测试 inspection.kts 脚本。
参数:
inspectionKtsCode:要编译和运行的 inspection.kts 脚本内容。contextPath:项目内需分析的目标文件相对路径(如 src/my/package/Example.kt )。targetFileContent:要分析的目标文件内容。 如未提供,该文件必须在项目中存在。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
补丁工具
- apply_patch
应用采用 Codex
apply_patch格式或统一 Git 差异格式的补丁。 支持添加、删除和更新操作,并为更新提供可选的移动目标路径。 路径必须位于项目目录内。参数:
input:apply_patch格式或统一 Git 差异格式的补丁文本。patch:input的别名,用于兼容发送{patch: ...}的客户端。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
读取工具
- 读取文件
读取项目目录、项目依赖项或其他项目源根目录中的文件。 可读取 Jar/Jrt 文件内的源代码,并可反编译 Jar/Jrt 文件或磁盘中的 Java 类文件。 以编号行(从 1 开始)返回文本。
模式:
slicelinesline_columnsoffsetsindentation
模式详情:
slice使用start_line和max_lines。lines使用start_line/end_line(包含上限)。line_columns使用start_line/start_column和end_line/end_column(end为排他;end_line默认为start_line)。offsets使用start_offset/end_offset(end为排他)。indentation使用start_line,并配合max_levels/include_*。
max_lines限定所有模式下的总输出数;context_lines适用于范围模式(每侧)。参数:
file_path:文件路径。 支持项目相对路径、带 '..' 的路径、绝对路径、类似 /path/lib.jar!/pkg/Foo .class 的归档条目,以及如 file:// 、 jar:// 和 jrt:// 等 URL。 可直接传入其他工具返回的任何路径(如来自search_*工具的路径)。mode:读取模式:slice、lines、line_columns、offsets或indentation。start_line:读取起始的 1 基行号。max_lines:要返回的最大行数(切片用作行数;所有模式均有限制输出)。end_line:lines/line_columns模式下 1 基结束行(lines为包含;line_columns为排他)。start_column:line_columns模式下 1 基起始列。end_column:范围读取的 1 基结束列(排他)。start_offset:offsets 模式下 0 基起始偏移(需要end_offset)。end_offset:offsets 模式下 0 基结束偏移(排他)。context_lines:范围周围包含的上下文行数(每侧)。max_levels:缩进模式:要包含的最大缩进层数(0 = 仅锚点块)。include_siblings:缩进模式:包含与锚点处于同一级缩进的同级块。include_header:缩进模式:包含锚点正上方的页眉注释/注解。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
重构工具
- rename_refactoring
在指定文件中重命名符号(变量、函数、类等)。 使用此工具执行重命名重构操作。
与简单的文本查找与替换不同,
rename_refactoring工具是一种具有上下文感知能力的工具,能够理解代码结构。 它会智能地更新整个项目中对指定符号的所有引用,确保代码完整性并防止引用丢失。 这始终是重命名程序符号的首选方法。如果重命名操作成功,工具将返回成功消息;如果找不到文件或符号,或重命名操作失败,则返回错误消息。
参数:
pathInProject:相对于项目根目录的路径。symbolName:要重命名的符号名称。newName:符号的新名称。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
搜索工具
- 搜索文件
通过 glob 模式在项目内搜索文件。 当需要用 glob 语法匹配文件路径时,请使用此工具。
Glob 模式相对于项目根目录。
示例:
"**/*.kt""src/**/Foo*.java""build.gradle.kts"
无
'/'的模式将按"**/pattern"处理。paths是相对于项目根目录的可选附加 glob 筛选器。参数:
q:要搜索的 glob 模式。paths:可选的项目相对 glob 模式筛选器列表,用于筛选结果。 支持!排除。 以/结尾将扩展为**。 无/的模式将按**/pattern处理。 空字符串将被忽略。includeExcluded:是否在结果中包含已排除/已忽略的文件。limit:要返回的最大结果数。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- 搜索正则表达式
在项目文件中根据正则表达式搜索匹配项。 当需要带代码段结果的正则表达式搜索时,请使用此工具。 结果包含匹配坐标(如有)(1 基行/列,0 基偏移量)。
路径为相对于项目根目录的 glob 模式。
示例:
["src/**", "!**/test/**"]["**/*.kt"]["foo/"]
参数:
q:要搜索的正则表达式模式。paths:可选的项目相对 glob 模式筛选器列表,用于筛选结果。 支持!排除。 以/结尾将扩展为**。 无/的模式将按**/pattern处理。 空字符串将被忽略。limit:要返回的最大结果数。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- 搜索符号
搜索符号(类、方法、字段)。 使用此工具可按标识符片段进行语义查询。 结果包含匹配坐标(如有)(1 基行/列,0 基偏移量)。
路径为相对于项目根目录的 glob 模式。
默认只搜索项目符号。 如未找到合适结果,可使用
include_external=true再试,进一步搜索 SDK 与库符号。参数:
q:符号查询文本。paths:可选的项目相对 glob 模式筛选器列表,用于筛选结果。 支持!排除。 以/结尾将扩展为**。 无/的模式将按**/pattern处理。 空字符串将被忽略。include_external:是否包含 SDK 和库中的符号。 默认禁用,如仍未找到合适项,可通过include_external=true再试。limit:要返回的最大结果数。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- 搜索文本
在项目文件中搜索文本子字符串。 使用该工具可快速文本搜索并获取代码段结果。 结果包含匹配坐标(如有)(1 基行/列,0 基偏移量)。
路径为相对于项目根目录的 glob 模式。
示例:
["src/**", "!**/test/**"]["**/*.kt"]["foo/"]
参数:
q:要搜索的文本。paths:可选的项目相对 glob 模式筛选器列表,用于筛选结果。 支持!排除。 以/结尾将扩展为**。 无/的模式将按**/pattern处理。 空字符串将被忽略。limit:要返回的最大结果数。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
技能搜索工具
- 技能搜索
使用显式模式执行统一项目搜索:
file:glob 路径搜索。text:文字内容搜索。regex:正则表达式内容搜索。symbol:语义符号查找。
符号搜索默认聚焦于项目。 如果未找到合适的符号,请使用
include_external=true再试一次,以同时搜索 SDK 和库符号。参数:
mode(必需):搜索模式:file、text、regex或symbol。q(必需):搜索查询。 对于mode=file,这是一个 glob 模式。paths:可选的项目相对 glob 筛选器。 支持!排除项和结尾的/。include_external:是否为mode=symbol包含 SDK 和库符号。 默认禁用;如果未找到合适的内容,请使用include_external=true再试一次。includeExcluded:是否包含已排除或已忽略的文件。 仅支持mode=file。limit:要返回的最大结果数。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
终端工具
- execute_terminal_command
在 IDE 的集成终端中执行指定的 shell 命令。 使用此工具在 IDE 环境中运行终端命令。
重要功能与限制:
在收集输出之前检查进程是否正在运行。
将输出限制为 2000 行(超出部分将被截断)。
在达到指定超时时间后终止,并显示通知。
除非在设置中启用了 Brave Mode ,否则需要用户确认。
返回可能的响应:
终端输出(若超过 2000 行将被截断)。
如果命令超时,则输出中包含中断通知。
各种失败情形下的错误消息。
参数:
command:要执行的 shell 命令。executeInShell:是否在用户的默认 shell(bash、zsh 等)中执行命令。 如果命令为 shell 脚本,或需要保留用户终端的真实环境时很有用。 如果设置为false,则该命令将作为一个进程启动。reuseExistingTerminalWindow:是否重用现有终端窗口,以避免创建多个终端。超时:超时时间(毫秒)。maxLinesCount:要返回的最大行数。truncateMode:如何截断文本:从开头、中间或结尾,或不进行截断。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
通用工具
- 执行工具
通用工具执行器,可从命令行字符串动态调用特定 IDE MCP 工具。
参数:
command(必需):包含工具名称和实参的命令行字符串。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
VCS 工具
- get_repositories
检索项目中的 VCS 根列表。 使用此工具识别多仓库项目中的所有仓库。
参数:
projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。
- Git 状态
检索当前项目中一个或多个仓库的 Git 状态。 返回 porcelain 风格的索引和工作树状态代码以及摘要计数器。 默认返回所有 Git 仓库。
参数:
repositoryPathRelativeToProject:相对于项目根的可选路径,用于选择单个包含该路径的仓库。includeUntracked:是否包含未跟踪的文件。includeIgnored:是否包含已忽略的文件。limit:每个仓库返回的最大条目数。projectPath:项目路径。 已知时请始终提供此值,以减少调用歧义。 如果仅知道当前工作目录,也可以将其用作项目路径。