データの問題を検出して修正する
PyCharm は、pandas DataFrame に読み込まれ、Jupyter Notebook セルに表示されているデータセットを自動で分析できます。 IDE は、欠損値、外れ値、重複行、重複した列名、定数列などの潜在的な問題をハイライト表示するため、モデリング前のデータクリーニングが容易になります。
PyCharm は、次の条件を満たす任意の DataFrame を自動で分析します:
100,000 行以下が含まれます。
200 列以下が含まれます。
df、df.head()、df[x:y]、df.loc(.. .)またはdf.iloc(...)を使用して表示されます。
少なくとも 1 つの問題が見つかった場合、DataFrame ツールバーに  データセットの問題 ボタンが表示されます。
AI でデータの問題を修正
DataFrame ツールバーの
データセットの問題 ボタンをクリックします。 「データセットの品質問題 」ダイアログが開きます。
修正する問題を選択し、 AI で修正 ボタンをクリックします。
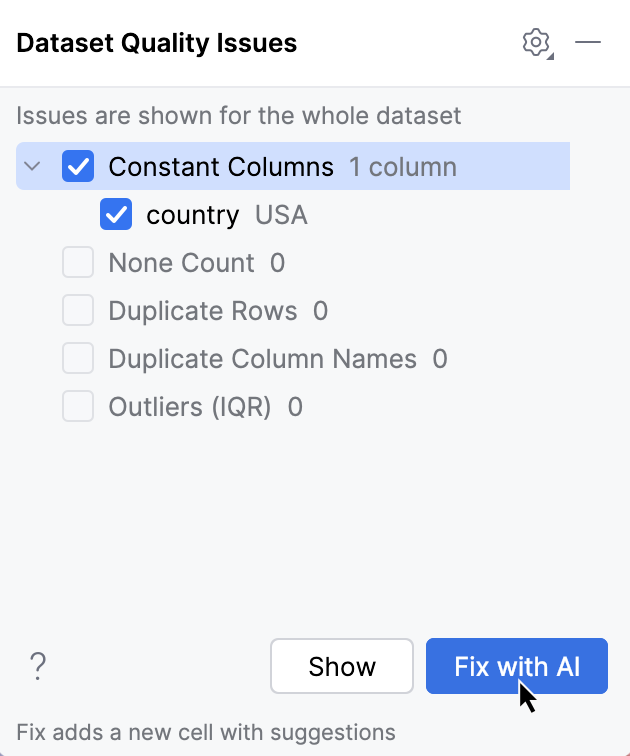
提案された変更が含まれた新しいコードセルが DataFrame に作成されます。
よくある問題とその対処方法
欠損値
データセット内の一部のセルには値がない場合があり、 NaN または なし として表されます。 これは、データ収集、マージ、ファイルのインポート中によく発生します。 これらの値を無視すると、分析にバイアスが生じる可能性があります。 また、一部の機械学習アルゴリズムは、欠損値を含むデータでは実行できません。
例: salary 列に 6 つの空のセルが見つかりました。
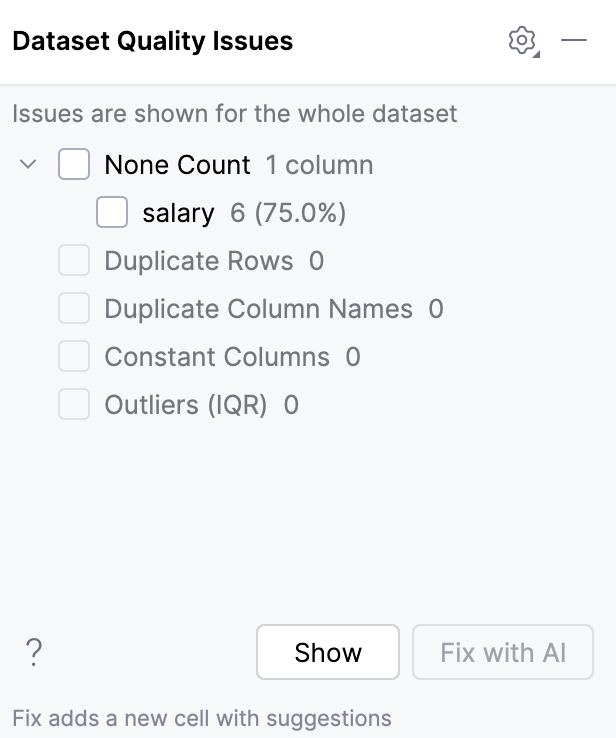
この問題に対処するための一般的な修正は次のとおりです。
不明な値が多すぎる行または列を削除します。
df = df.dropna()不明な値を
0やUnknownなどの定数に置き換えます。df['Name'] = df['Name'].fillna('Unknown')不明な値を列の平均値、中央値、最頻値に置き換えます。
df = df.fillna(df.mean())線形回帰や k 最近傍法などの機械学習モデルを使用して欠損値を予測および置換する:
from sklearn.impute import KNNImputer imputer = KNNImputer(n_neighbors=5) df_imputed = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)
重複する列名
データセットには、たとえば列名を手動で割り当てた後やデータセットを結合した後などに、同じ名前の列が複数含まれる場合があります。 重複した列名により列の選択があいまいになり、データ処理中に予期しない結果につながる可能性があります。
たとえば、データセット内に名前が重複している二つの列が見つかりました:
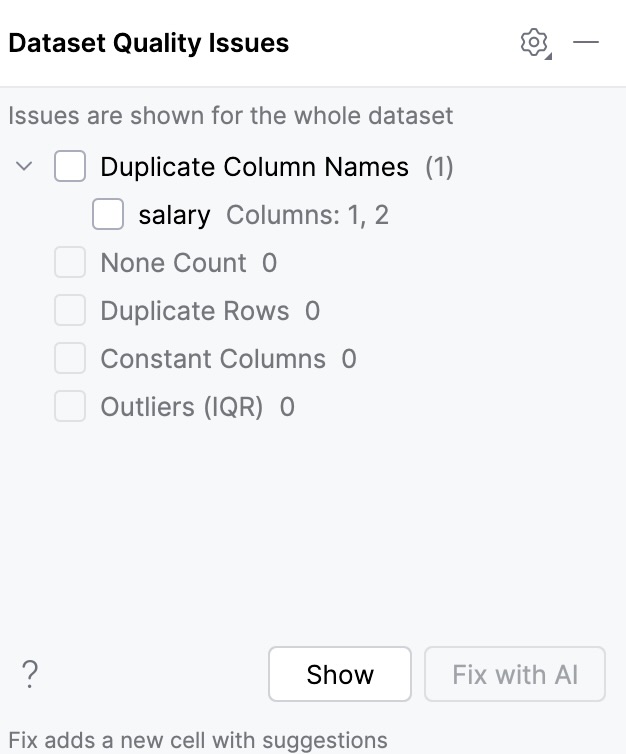
この問題に対処するための一般的な修正は次のとおりです。
重複した列の名前変更
冗長なデータが含まれている場合に重複した列を削除する:
df = df.loc[:, ~df.columns.duplicated()]
重複行
データセット内の一部の行は、たとえば繰り返しのインポートやログエラーなどにより、同一のデータになっている場合があります。 これを無視すると、バイアスが生じ、統計結果の信頼性が低下する可能性があります。
例: データセット内に重複する 2 つの行が見つかりました。
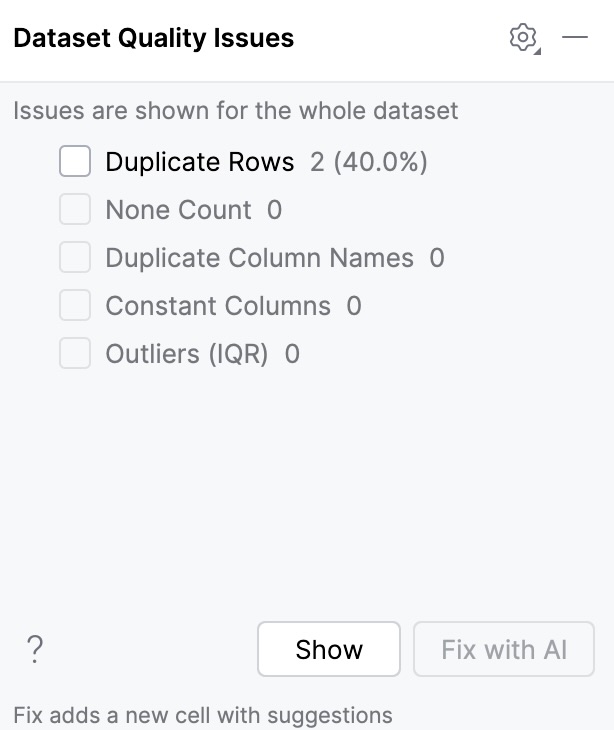
この問題に対処するための一般的な修正は次のとおりです。
重複する行をすべて削除します。
df = df.drop_duplicates()最初の出現を除くすべての重複を削除します。
df = df.drop_duplicates(keep='first')
外れ値
外れ値とは、データセット内の他のほとんどの値と大きく異なるデータポイントです。 統計結果を歪め、機械学習モデルに影響を及ぼす可能性があります。
PyCharm は、四分位範囲 (IQR) メソッドを使用して外れ値を検出します。 値が Q1 - 1.5 × IQR を下回るか Q3 + 1.5 × IQR を上回る場合、外れ値と見なされます。ここで、 Q1 と Q3 は第一四分位数と第三四分位数です。
一般的に、外れ値は、ターゲットとする母集団とは異なる母集団に属していると考えられる場合にのみ削除することをお勧めします。 詳細については、 この記事を参照してください。
例: salary 列と age 列に外れ値が見つかりました:
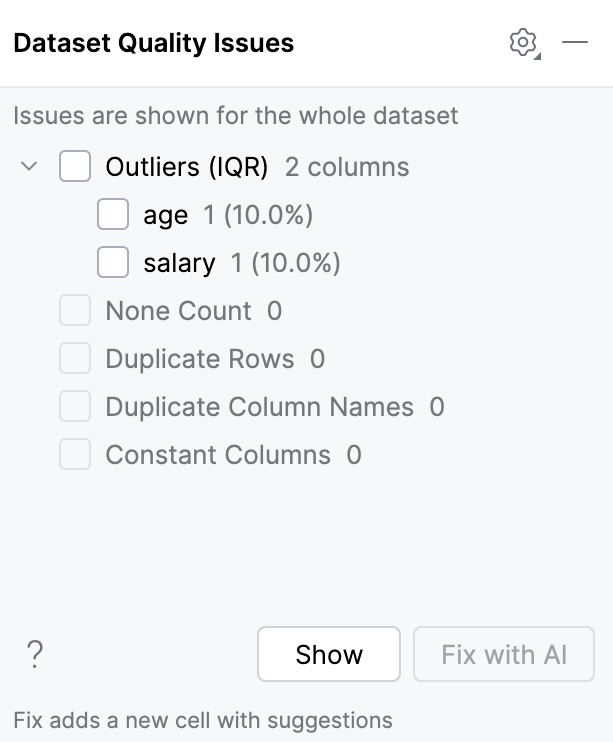
この問題に対処するための一般的な修正は次のとおりです。
IQR などの統計的メソッドを使用して極端な値を見つける:
Q1 = df["salary"].quantile(0.25) Q3 = df["salary"].quantile(0.75) IQR = Q3 - Q1 outliers = df[ (df["salary"] < Q1 - 1.5 * IQR) | (df["salary"] > Q3 + 1.5 * IQR) ]極端な値を持つ行を削除します。
df = df[df['salary'] < 20000]極端な値をしきい値に制限する:
df['salary'] = np.where(df['salary'] > 20000, 20000, df['salary'])外れ値の影響を減らすために値を変換する(たとえば、対数変換を適用する):
df['salary_log'] = np.log1p(df['salary'])
定数列
データセット内の一部の列には、すべての行で同じ値が含まれている場合があります。 このような定数列は変動性がないため、分析やモデルに有用な情報をもたらさないことがよくあります。
例: 定数値 USA を持つ列 country が見つかりました:
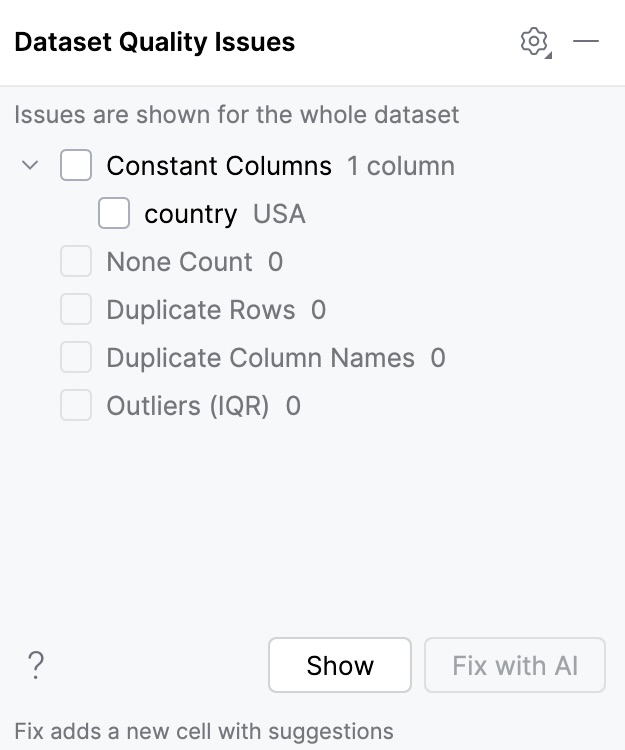
この問題を処理するための一般的な修正方法は次のとおりです:
すべての単一値列を削除します。
df = df.drop(columns=single_value_cols)