データ抽出ツール
データベースツールおよび SQL プラグインを有効化する
この機能は、RubyMine にデフォルトでバンドルされ有効化されている データベースツールおよび SQL プラグインに依存しています。 関連機能が利用できない場合は、プラグインを無効化していないことを確認してください。
Ctrl+Alt+S を押して設定を開き、 を選択します。
データベースツールおよび SQL プラグインを見つけて、 有効化 をクリックします。
データ抽出は、エディター (テキスト エディター表示モード) でデータをコピーまたは表示する方法のルールを設定します。 データをエクスポート アイコン ( ) の近くにある データ抽出 リストからデフォルトのエクストラクターを選択したり、既存のエクストラクターを構成したり、Groovy または JavaScript を使用してカスタムエクストラクターを作成したりできます。
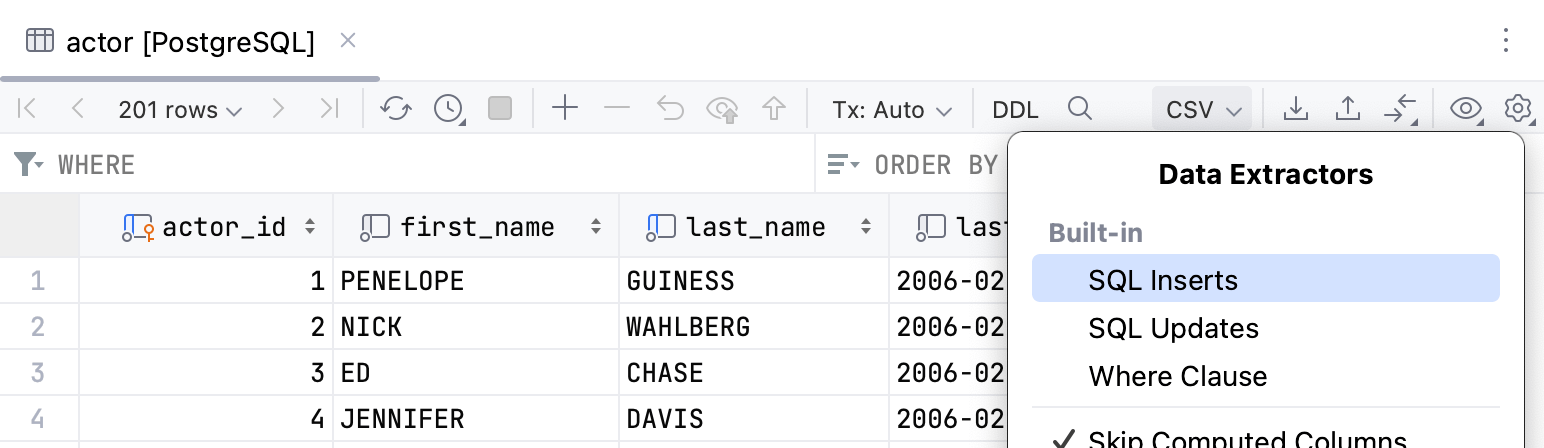
最後に選択したエクストラクターが、新しく開いたエディタータブのデフォルトのエクストラクターになります。 MongoDB の場合、デフォルトのエクストラクターは常に JSON です。
次のビデオでは、 CSV データ抽出器を使ってデータをコピーし、 テキスト エディター表示モードで SQL の UPDATE と パイプ区切り データ抽出器を使って表示しています。
データ抽出機能を使用すると、データベースデータを SQL 文としてさまざまな形式でエクスポートできます。 ファイルにエクスポートすると、テーブルまたはビューごとに個別のファイルが作成されます。 エクスポートの詳細については、 「エクスポート」セクションを参照してください。
サポートされているファイル形式
利用可能なスクリプトとサポートされているファイル形式のリストは次のとおりです:
定義済みスクリプト。 これらを使用して、
INSERTまたは更新ステートメント、 TSV と CSV(英語) ファイル、 エクセル XLSX(英語) ファイル、 Markdown(英語) 、HTML テーブル、 JSON(英語) 形式のセットとしてデータをエクスポートします。ビルトイン
スクリプト
ファイルフォーマット
SQL の INSERT
.sql
SQL の UPDATE
Where 句
CSV
スクリプト
ファイルフォーマット
CSV
.csv
TSV
.tsv
パイプ区切り
.txt
CSV 形式の設定を使用して、CSV または任意の DSV 形式に基づいた独自の形式を作成します。
スクリプト
スクリプト
ファイルフォーマット
CSV
.csv
TSV
.tsv
Excel
.xlsx 、 .xls
HTML (groovy)
.html
HTML (js)
JSON
.json
Markdown
.md
One-row
.sql
SQL-Insert-Multirow
SQL-Insert-Statements
Pretty
.txt
XML
.xml
カスタムデータ抽出器。 Groovy または JavaScript と提供された API を使って作成できます。
区切り文字で区切られた値のエクストラクターを構成する
デフォルトの機能を拡張し、CSV または任意の DSV 形式に基づいて独自の形式を作成できます。 設定では、行とヘッダーの区切り文字を設定したり、NULL 値のテキストを定義したり、引用符を指定したり、区切り文字で区切られた値を持つ形式の新しい抽出子を作成したりできます。
データエクストラクターのリストから、 CSV フォーマットの設定 を選択します。
CSV フォーマット ダイアログで、 フォーマットを追加 アイコン
 をクリックします。
新しい形式の名前を指定します (たとえば、
Confluence Wiki マークアップ)。フォーマットの設定を定義します:行やヘッダーの区切り文字を指定し、NULL 値のテキストを定義し、クォーテーションを指定します。 OK をクリックしてください。
フォーマットが作成されると、 データをエクスポート アイコン (
) の近くのドロップダウンで選択できます。
CSV フォーマット ダイアログの詳細については、 リファレンスを参照してください。
カスタムエクストラクターを追加する
Groovy または JavaScript で記述可能な独自の抽出器を作成できます。
GitHub リポジトリ(英語)でスクリプト拡張機能開発用の事前構成済みプロジェクトを見つけます。
プロジェクト ツールウィンドウで、 Scratches and Consoles | Extensions | データベースツールおよび SQL | data | extractors に移動します。
extractors ノードを右クリックし、 を選択します。
ファイル名を入力します (例:
PHP.配列.Groovy=)。PHP: 抽出メニューで使用される名前。配列: エクストラクターの出力。Groovy: スクリプトの拡張子。
抽出プログラムのコードを入力するか、新しいファイルに貼り付けます。 extractors フォルダー内の他のエクストラクターのコードを使用して、エクストラクターを作成できます。 また、次のエクストラクターを試すこともできます。
GitHub の TSV-Icelandic-Groovy.tsv.groovy(英語): タブ区切りのクエリ結果をコピーして、Excel にコンマ区切りで貼り付けます。
GitHub 上の Groovy での Dbunit データセットのエクスポート (英語): Dbunit エクスポート用のエクストラクター。
Table-Text-Groovy.txt.groovy(英語) および Fixed-length-fields.txt.groovy(英語): 固定長の列を含む txt ファイルを生成するエクストラクター。
PHP-Array.groovy(英語): PHP 配列へのエクストラクター。
Markdown-JavaScript.markdown.js(英語): Markdown へのエクストラクター。
抽出器のリストから抽出器を選択します。
RubyMine に PHP 配列抽出器を追加する以下の例を考えます。
カスタムデータエクストラクターの API
以下の API を使ってカスタムデータ抽出器を作成します。
バインディング | メソッド (Groovy と JavaScript) | 説明 |
|---|---|---|
|
| データベース ダイアレクト |
|
| データベーステーブルのメタデータ |
|
| クエリ結果または現在開いているテーブルエディター内のすべての列のリスト。 |
|
| クエリ結果または現在開いているテーブルエディターで選択されている列のリスト。 |
|
| デフォルトのフォーマットメソッド。 |
|
| 抽出器の出力。 |
|
|
|
TRANSPOSED | テーブルエディターが転置モードかどうかを示すブール値。 |
サンプル
以下のシンプルな CSV データ抽出ツールを、カスタムデータ抽出ツールのベースとして使用できます。 このデータ抽出ツールのフルバージョンは RubyMine で入手できます。 プロジェクト ツールウィンドウで Scratches and Consoles | Extensions | データベースツールおよび SQL | data | extractors に移動してください。
リファレンス
CSV フォーマットダイアログ
このダイアログにアクセスするには、ツールバーの データ抽出 リストをクリックし、 CSV フォーマットの設定 を選択します。
このダイアログには、テーブルデータを区切り文字で区切った値形式(例:CSV、TSV)に変換したり、その逆に変換したりするための設定が含まれています。
残りのデータが読み込まれないようにするため、プレビューは 10 件のレコードに制限されています。 設定を変更すると、プレビューもそれに応じて変更されます。
項目 | 説明 |
|---|---|
フォーマット | ファイルデータをテーブルに正常に変換するテンプレートを選択します。 事前定義されたテンプレートの設定を変更したり、新しいテンプレートを追加したりできます。 テンプレートを追加するには、 フォーマットを追加 ボタン( フォーマットを追加 ( |
値セパレーター | 値の区切り記号として使用する文字を選択または入力します。 |
行セパレーター | 行の区切り記号として使用する文字を選択または入力します。 |
null 値テキスト | セルに |
行接頭辞 / 接尾辞の追加 | リンクをクリックして、行の接頭辞と接尾辞を入力します。 接頭辞と接尾辞は文字シーケンスであり、改行コードに加えて行の開始と終了を示します。 |
引用符 | 引用符 の領域の各行は、引用パターンです。 見積もりパターンには次のものが含まれます。
複数のパターンがある場合は、最初のパターンが使用されます。 追加 ( |
値を引用符で囲む | 値を引用符文字で囲む場合に選択します。
|
空白をトリムする | 空白文字を無視または削除します。 このチェックボックスがオフの場合、空白文字は対応する値の一部として扱われます。 |
最初の行はヘッダー | 最初の行を列名を含む行として扱います。 |
最初の列はヘッダー | 最初の列を行名を含む列として扱います。 |
 )をクリックします。
 )、
 )、および
 ) ボタンを使用してフォーマットを作成、削除、リオーダーします。
 ) を使用して選択したフォーマットのコピーを作成します。